ITエンジニアにお勧めの本 ↗

技術スキル以上に大切な「考え方」をアップデートできる。世界基準の効率的な仕事術が学べます。

文系社会人のためのIT資格の歩き方: 文系のあなたに最適な道をご提案します (YKcreate kiki)
ロードマップが非常に明確。キャリアプランを見据えた、無駄のない学習順序を提案してくれます。

エンジニアを説明上手にする本 相手に応じた技術情報や知識の伝え方
「伝える技術」もエンジニアの重要なスキル。相手の視点に立った、具体的な説明のコツが満載です。

技術広報入門 ー テックブログから始めるエンジニアカルチャーのつくり方
テックブログを入口にエンジニア組織の文化をどう設計し、育てていくかという実践論が学べます。
データベース(RDBMS)で大量のデータを高速に検索するために欠かせない仕組みが インデックス(索引) です。そのインデックスの代表格であり、MySQLMySQL [マイエスキューエル]オープンソースのリレーショナルデータベース(InnoDB)やPostgreSQLPostgreSQL [ポストグレスキューエル]高機能オープンソースのリレーショナルデータベース、Oracleなど主要なデータベースで標準的に採用されているのが Bツリー(B-Tree)インデックス です。
基本情報技術者試験や応用情報技術者試験のデータベース分野でも頻出のテーマですが、学習を始めたばかりのときは次のような疑問を持ちやすい分野でもあります。
- 「Bツリーインデックスって名前は聞くけれど、なぜ数百万件ものデータから一瞬で目的の行を見つけられるの?」
- 「普通の二分探索木(バイナリツリー)やハッシュインデックスとは何が違うの?」
- 「教科書に出てくる Bツリー と、実際のデータベースで使われる B+ツリー はどう違うの?」
- 「インデックスを貼れば貼るほど検索は速くなるのに、なぜやたらと追加してはいけないと言われるの?」
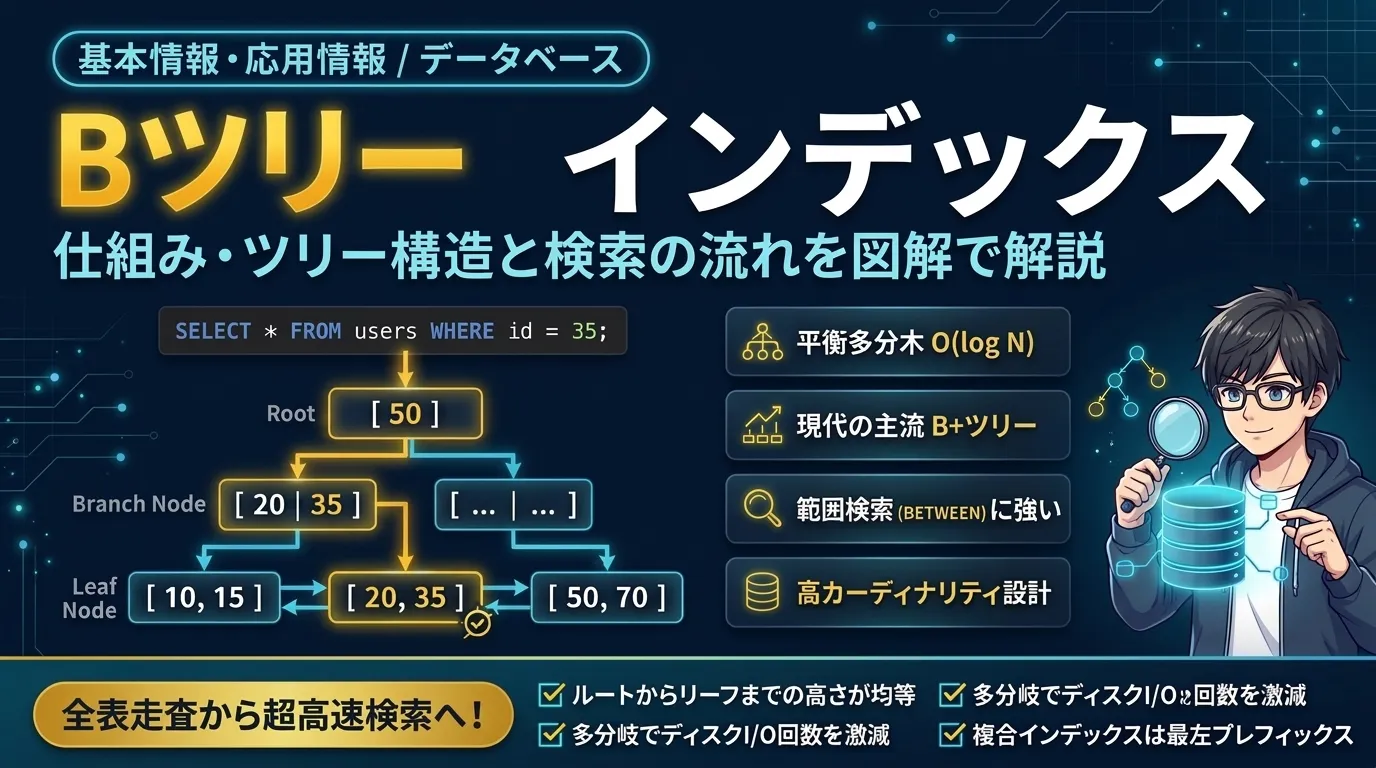
この記事では、Bツリーインデックスの基礎概念から、ルート・ブランチ・リーフで構成される木構造、データが検索される具体的なステップ、B+ツリーとの違い、試験対策や実務でのインデックス設計の急所までを図解とともにわかりやすく解説します。
Bツリーインデックスとは?一言でわかりやすく解説
Bツリーインデックス(B-Tree Indexindex [インデックス]検索を高速化するためのデータ構造)とは、一言でいうと 「 データを常にソートされた多分木(平衡木)として保持し、何千万件ものレコードの中からわずか数回の探索で目的のデータを見つけ出せるデータベースの索引構造 」 です。
「B」の由来は考案者(Rudolf Bayer と Edward McCreight、1970年代初頭)が明言しておらず、 Balanced(平衡) 、Bayer、当時の所属先 Boeing など諸説あります。名前の由来にかかわらず、Bツリーはルートからどのリーフまでの深さも常に均等に保たれる「平衡木」であることが最大の特徴です。そのため、データ量が膨大になっても検索性能が極端に悪化することがありません。
実社会の「国語辞典のツメ(見出し)と五十音順の索引」に例えるとわかりやすい
データベースにインデックスがない状態は、ページ番号も目次も五十音順の並び替えもない「バラバラに単語が書かれた1,000ページのノート」から特定の単語を探すようなものです。
目的の単語を見つけるには、最初の1ページ目から最後のページまで1行ずつめくって確認するしかありません。これをデータベース用語で フルテーブルスキャン(全表走査) と呼びます。
一方、Bツリーインデックスを適用したデータベースは、きれいに整理された 国語辞典(辞書) に例えることができます。
| 比較項目 | フルテーブルスキャン(全表走査) | Bツリーインデックス |
|---|---|---|
| 実社会での例え | 順不同で書かれたノートを1行ずつ探す | 国語辞典の「あかさたな」のツメから引く |
| 検索の手順 | 1ページ目から最後のページまで順番に読む | 「さ行」→「す」→「すいか」と絞り込む |
| 探す回数の目安(100万件時) | 最悪1,000,000回のチェックが必要 | わずか3〜4回のノード参照で到達 |
| データの並び順 | 格納された順番(物理的な書き込み順) | キーの値順に整列(ソート済み) |
| 得意な検索 | テーブル全体の集計や大量の行取得 | 特定の1件検索や特定範囲(範囲検索) |
国語辞典で「すいか」という言葉を引くとき、私たちは「あ」から順番に全単語を読む人はいません。まず側面のツメで「さ行」を開き、次に「す」のページへ進み、最後に五十音順に並んだ項目から「すいか」を見つけ出します。
Bツリーインデックスもまったく同じ仕組みで、データを段階的に絞り込むことで、最小限のアクセス回数で目的のレコードに到達します。
Bツリーの構造:3種類のノードで成り立つ「逆さの木」
ITの世界における「木構造(ツリー構造)」は、植物の木とは逆で、根っこが一番上にあり、下に向かって枝や葉が広がっていく形で表現されます。
Bツリーは、役割の異なる 3種類のノード(節点) で構成されています。
キー: [ 50 ]
検索の開始地点"] BranchL["【ブランチノード(中間)】
キー: [ 20, 35 ]
50未満の範囲"] BranchR["【ブランチノード(中間)】
キー: [ 70, 85 ]
50以上の範囲"] Leaf1["【リーフノード(葉)】
10, 15"] Leaf2["【リーフノード(葉)】
20, 28"] Leaf3["【リーフノード(葉)】
35, 42"] Leaf4["【リーフノード(葉)】
50, 63"] Leaf5["【リーフノード(葉)】
70, 80"] Leaf6["【リーフノード(葉)】
85, 95"] Root -->|50未満| BranchL Root -->|50以上| BranchR BranchL -->|20未満| Leaf1 BranchL -->|20以上35未満| Leaf2 BranchL -->|35以上| Leaf3 BranchR -->|70未満| Leaf4 BranchR -->|70以上85未満| Leaf5 BranchR -->|85以上| Leaf6 end
1. ルートノード(Root Node:根ノード)
探索のスタート地点となる最上位のノードです。1つのインデックスにつき1つだけ存在し、検索処理は必ずこのルートノードから始まります。
2. ブランチノード(Branch Node:中間ノード / 内部ノード)
ルートノードとリーフノードの間に位置するノードです。実際のRDBMSで使われるB+ツリー(後述)では、ブランチノードはデータそのものは持たず、検索対象のキー値が「どの範囲のリーフノードにあるか」を示す 道案内(ポインタ) の役割を果たします。階層が深くなると複数レベルのブランチノードが存在します。
3. リーフノード(Leaf Node:葉ノード)
ツリーの一番底にある末端のノードです。ここにはソートされた実際の インデックスキー値 と、対応するテーブル本体の行を指し示す 行ポインタ(ROWIDや主キー値) が格納されています。
平衡木(Balanced Tree)であることの重要性
Bツリーの最大の特徴は、 「 どのリーフノードまでの深さ(高さ)も常に一定である 」 という点です。
一般的な二分探索木では、昇順(1, 2, 3, 4, 5…)のように偏ったデータを連続して挿入すると、片側だけに枝が伸びて直線状(リスト構造)になってしまい、検索速度が著しく低下(最悪計算量が O(N))する弱点があります。
しかしBツリーは、データの追加や削除が行われても、ノードの分割(Split)や統合(Merge)を自動的に実行して 常に木のバランスを均等に保ちます 。これにより、どのようなデータであっても最悪計算量が O(log N) に保証されます。
Bツリーインデックスでデータが検索される仕組み
それでは、具体的に数値キーを使ってデータが検索されるステップを見てみましょう。
例として、キー値 35 を検索する場合(SQLSQL [エスキューエル / シークエル]Structured Query Language。関係データベース(RDB)の管理や操作を行うデータベース言語: SELECT * FROM users WHERE id = 35;)の探索手順を追っていきます。
等価検索(WHERE id = 35)の探索ステップ
- ルートノードの確認: ルートノードのキー
[ 50 ]と検索値35を比較します。35 < 50なので、左側の子ノード(ブランチノード)へ進みます。 - ブランチノードの確認: 左のブランチノードには
[ 20, 35 ]というキーがあります。検索値35は「35以上」の範囲に該当するため、右端の子ノード(キー35, 42を持つリーフノード)へ進みます。 - リーフノードで実キーを取得: リーフノード内で整列されているキーから
35を発見します。ここに格納されているテーブル本体の行位置情報(ROWIDなど)を取り出します。 - テーブル実データの取得(テーブルアクセス): 取得したROWIDを元に、テーブル本体のデータブロックを1回だけ読み込んで目的のレコードを返却します。
このように、ノードをわずか 3回 辿るだけで目的のデータに到達できました。データが1,000万件あっても、Bツリーの高さは通常 3〜4階層 程度に収まるため、たった3〜4回のディスク読み込みで目的の行を特定できます。
範囲検索(BETWEEN や不等号)の動き
Bツリーのもう一つの強みは、 WHERE id BETWEEN 20 AND 50 や WHERE created_at >= '2026-01-01' のような 範囲検索(レンジスキャン) が非常に得意な点です。
リーフノード内のデータは最初からキーの昇順で並んでいるため、範囲の開始点(20)をツリー探索で一度特定した後は、そこから順番に隣のデータを走査していくだけで範囲内の全データを高速に取得できます。
BツリーとB+ツリーの違い:現代のDBがB+ツリーを使う理由
教科書では総称して「Bツリーインデックス」と呼ばれますが、実はMySQLのInnoDBやPostgreSQL、Oracleなど、 現代の商用・OSSデータベースのほぼすべてが「B+ツリー(ビープラスツリー)」という改良型構造を採用 しています。
両者の最大の違いは、 「 データ(実データやROWID)を保持する場所 」 と 「 リーフノード同士のつながり 」 にあります。
(キーとポインタのみ)"] BPBranch["ブランチノード
(キーとポインタのみ)"] BPLeaf1["リーフノード A
[キー + 行ポインタ]"] BPLeaf2["リーフノード B
[キー + 行ポインタ]"] BPLeaf3["リーフノード C
[キー + 行ポインタ]"] BPRoot --> BPBranch BPBranch --> BPLeaf1 BPBranch --> BPLeaf2 BPBranch --> BPLeaf3 BPLeaf1 <-->|双方向ポインタ| BPLeaf2 BPLeaf2 <-->|双方向ポインタ| BPLeaf3 end
| 比較項目 | 元祖 Bツリー(B-Tree) | B+ツリー(B+ Tree / 現在の主流) |
|---|---|---|
| 実データの保持場所 | ルート・ブランチ・リーフの 全ノード | リーフノードのみ に集約 |
| 内部ノードの役割 | キー値 + 実データ + 子ノードポインタ | キー値 + 子ノードポインタのみ (案内係に特化) |
| リーフノードの連結 | なし(独立している) | リンクリスト で水平に連結(InnoDBやPostgreSQLは双方向) |
| 1ノードに格納できるキー数 | データも持つため少数しか入らない | キーだけなので 大量のキー を格納可能 |
| ツリーの高さ(階層数) | 高くなりやすい(ディスクI/O増) | 極めて低く保てる(3〜4層で数千万件) |
| 範囲検索(レンジスキャン) | 中間順走査で上位ノードとの行き来が必要 | リーフの横のリンクを順次辿るだけで効率的 |
なぜB+ツリーが優れているのか?
データベースのパフォーマンスを左右する最大のボトルネックは、ストレージ(SSDSSD [エスエスディー]Solid State Drive。フラッシュメモリを用いた高速な記憶装置やHDDHDD [エイチディーディー]Hard Disk Drive。磁気ディスクを用いた大容量の記憶装置)との ディスクI/O です。
- ツリーの高さを低く抑えられる(ファンアウトの増大): データベースはディスクからデータを ブロック(ページ)単位(例: 16KB) で読み込みます。ブランチノードにデータを持たせずキーとポインタだけに絞ると、1つのブロック(16KB)の中に数百〜数千個もの分岐情報(ファンアウト)を詰め込むことができます。その結果、数千万行のテーブルであってもツリーの高さがわずか3〜4階層で収まります。
- 範囲検索(Range Scan)が効率的: B+ツリーではリーフノード同士がポインタで横に数珠つなぎになっています。そのため、範囲の先頭を見つけた後はツリーの上層に戻る必要がなく、リーフノードを横方向に順番に読むだけで範囲走査が完了します。
他の探索・インデックス方式との比較
データベースやデータ構造には、Bツリー以外にもさまざまな方式が存在します。それぞれの特徴と使い分けを整理しておきましょう。
| インデックス・探索方式 | 得意な処理 | 不得意な処理 | 主な用途・特徴 |
|---|---|---|---|
| Bツリー / B+ツリー | 等価検索(=)、範囲検索(BETWEEN, <, >)、前方一致、ソート(ORDER BY) | 中間一致・後方一致(LIKE '%abc') | RDBMSのデフォルトインデックス。汎用性No.1 |
| ハッシュインデックス | 完全一致検索(=)が O(1) で超高速 | 範囲検索、ソート、前方一致が一切できない | メモリ内の一時テーブル、オンメモリDB(RedisRedis [レディス]インメモリの高速キー・バリューデータストアなど) |
| ビットマップインデックス | カーディナリティ(値の種類)が極めて低い列のAND/OR検索 | データの頻繁なINSERT/UPDATE(ロック競合) | データウェアハウス(DWH)、BIBI [ビーアイ]Business Intelligence。蓄積されたデータを分析・可視化し、経営の意思決定に役立てる手法やツール分析系DB |
| フルテキストインデックス | 全文検索(文書内のキーワード検索、自然言語検索) | 数値の範囲検索や通常の一致検索 | 検索エンジン(ElasticsearchElasticsearch [エラスティックサーチ]分散型全文検索エンジン等)、大量テキスト検索 |
二分探索木(Binary Search Tree)ではダメなのか?
アルゴリズムの学習で最初に登場する「二分探索木」は、1つのノードから最大2本しか枝分かれしません。
もし100万件のデータを二分木で管理すると、木の高さは log2(1,000,000) ≒ 20階層 に達します。データベースで20階層を探索するということは、 1回の検索で最大20回のディスクI/Oが発生する ことを意味し、ディスクアクセスが遅いストレージ環境では致命的な速度低下を招きます。
Bツリー(B+ツリー)のように枝分かれ数(分岐数)を数百〜数千に増やす(多分木にする)ことで、ディスクI/O回数を最小限(3〜4回)に抑える工夫がなされているのです。
基本情報・応用情報試験での出題ポイント
情報処理技術者試験(基本情報・応用情報)のテクノロジ系・データベース分野では、Bツリーインデックスに関する理論的な特徴や計算問題が出題されます。
1. 探索回数のオーダーと計算問題
- 計算量(オーダー): Bツリーの探索計算量は
O(log N)です(二分探索と同様の対数オーダー)。 - 木の高さの計算: ノードの最大分岐数を $M$、キー数を $N$ とすると、木の高さ $h$ はおよそ $\lceil \log_M N \rceil$ 程度となります。分岐数 $M$ が大きいほど木の高さが低くなり、探索時のブロックアクセス回数が減ります。
2. インデックスが効く条件・無効になる条件
試験や実務で最も引っかかりやすいのが「インデックスが使われないケース」です。
- ⭕ インデックスが効くケース:
- 完全一致:
WHERE user_id = 100 - 範囲指定:
WHERE age >= 20 AND age < 30 - 前方一致:
WHERE name LIKE '田中%'(PostgreSQLでC以外の照合順序を使う場合はtext_pattern_ops演算子クラスが必要になるなど、DB製品の設定に依存します) - ソートの省略:
ORDER BY id(すでに並んでいるためソート処理が不要)
- 完全一致:
- ❌ インデックスが使われにくい(全表走査になりやすい)ケース:
- 中間一致・後方一致:
WHERE name LIKE '%田中'(先頭から探せないためツリーを辿れない) - 列への演算や関数適用:
WHERE YEAR(created_at) = 2026やWHERE price * 1.1 > 1000(同じ式で作成した関数インデックス/式インデックスがあれば利用可能) - 否定条件:
WHERE status <> 'deleted'またはWHERE status NOT IN (...)(該当行が多いためオプティマイザが全表走査を選びやすい) - NULLnull [ヌル / ナル]値が存在しないことを表す特殊な値判定(DB製品の実装による):
WHERE email IS NULL(OracleはすべてのキーがNULLの行をBツリーに格納しないため使えませんが、MySQLやPostgreSQLでは利用できます)
- 中間一致・後方一致:
最終的にインデックスを使うかどうかはDBのオプティマイザが統計情報をもとに判断するため、実際の挙動は EXPLAIN で実行計画を確認するのが確実です。
データベースのトランザクション管理やACID特性について復習したい方は、以下の記事もあわせて参考にしてください。
絶対忘れない!ACID特性の覚え方【語呂合わせ】
「ACID特性 覚え方」を知りたい方へ。語呂合わせ・実例で楽しく暗記をしましょう。初心者にもわかるACID特性・トランザクションの基本を具体的な例を交えて解説します。
実務でのBツリーインデックス設計:現場で失敗しない4箇条
現場のデータベース設計でよくあるトラブルが、「検索が遅いからとりあえず全部の列にインデックスを貼ろう」として、逆にシステム全体のパフォーマンスを崩壊させてしまうケースです。実務では以下の4原則を徹底しましょう。
1. カーディナリティ(Cardinality:値の種類の多さ)を意識する
インデックスを貼るべき列は、 カーディナリティ(値のユニーク度)が高い列 です。
- ⭕ カーディナリティが高い列(インデックス向き): ユーザーID、メールアドレス、注文番号、UUID(数万〜数百万人の中で値がほぼ重複しない)
- ❌ カーディナリティが低い列(インデックス不向き): 性別(男/女)、フラグ(0/1)、ステータス(未処理/処理中/完了)
値の種類が2〜3種類しかない列にBツリーインデックスを貼っても、1回の分岐で候補をほとんど絞り込めず、インデックスを引いてからテーブル本体を見に行くオーバーヘッドのほうが大きくなり、かえって遅くなることがあります(多くのオプティマイザはこの場合インデックスを使わず全表走査を選びます)。
2. 複合インデックス(複数列インデックス)は「最左プレフィックスルール」に従う
複数の列を組み合わせた複合インデックス(例: INDEX(shop_id, status, created_at))を作成する場合、 原則として左側の列から順番にWHERE句で指定しないとインデックスを効率よく使えません 。
- ⭕
WHERE shop_id = 10(第1キーを指定しているので有効) - ⭕
WHERE shop_id = 10 AND status = 'open'(第1・第2キーを指定しているので有効) - ❌
WHERE status = 'open'(第1キーのshop_idがないため通常のツリー探索ができない) - ❌
WHERE created_at >= '2026-01-01'(第1キーがないため通常のツリー探索ができない)
なお、Oracleの「インデックス・スキップ・スキャン」やMySQL 8.0.13以降の「Skip Scan」、SQLiteSQLite [エスキューライト]組み込み型の軽量SQLデータベースのスキップスキャンのように、先頭列のカーディナリティが低い場合に限って先頭列を飛ばしてインデックスを利用できる最適化を備えたDBもあります。ただし効率は通常の探索より劣るため、設計時は最左プレフィックスルールを前提に考えましょう。
複合インデックスを作成する際は、等価条件(=)で最もよく絞り込まれる列を一番左に配置するのが鉄則です。
3. 書き込み(INSERT / UPDATE / DELETE)のオーバーヘッドを忘れない
インデックスは検索(SELECT)を高速化しますが、データの追加・更新・削除が発生するたびに、 裏でインデックスへのキーの挿入・削除と、必要に応じたノード分割・統合(バランシング) が行われます。
インデックスが10個貼られたテーブルに1行INSERTすると、テーブル本体への書き込み1回に加えて、10個のインデックスツリーすべてを更新する書き込みが発生します。更新の激しいテーブルではインデックスを必要最小限に絞ることが重要です。
障害時のデータ保護や更新の一貫性を保つ仕組みについては、ロールバックとロールフォワードの解説記事も役立ちます。
ロールバックとロールフォワード|意味・違い・覚え方
ロールバックとロールフォワードの違いを徹底解説します。データベースやシステム開発で欠かせない「ロールバック」と「ロールフォワード」。それぞれの意味や使いどころ、具体例、そして覚え方までを図解付きでわかりやすく紹介。トランザクション制御や障害復旧に関わる方に必見の内容です。
4. カバリングインデックス(Covering Index)を活用する
クエリが必要とするすべての列がインデックスツリー内に含まれている場合、データベースは テーブル本体(実データ)を見に行くディスクI/Oを完全にスキップ できます。これを カバリングインデックス と呼び、テーブルアクセスを省いた分だけ高速にクエリを完了させることができます(PostgreSQLの Index Only Scan では、可視性マップの状態によってテーブル参照が残る場合があります)。
まとめ
今回は、データベース高速化の要である Bツリーインデックス(B-Tree Index) の仕組みについて解説しました。
最後に、重要ポイントを箇条書きで振り返りましょう。
- Bツリーの本質: データを整列された状態で保持し、ルートからリーフまで常に同じ深さを保つ「平衡多分木(Balanced Tree)」。検索の計算量は常に
O(log N)。 - 逆さの木構造: 探索は一番上の「ルートノード」から始まり、「ブランチノード」の道案内を経て、末端の「リーフノード」に到達する。
- 現代の標準はB+ツリー: 内部ノードはキーのみを保持してファンアウトを最大化(ツリーの高さを3〜4階層に抑制)し、リーフノード同士をリンクリストで連結して範囲検索を高速化している。
- インデックス設計の鉄則: カーディナリティの高い列に作成する、複合インデックスは最左プレフィックスを意識する、更新負荷(INSERT/UPDATE)とのトレードオフを計算する。
データベースの内部動作やデータ構造の原理を理解しておくと、基本情報・応用情報の試験対策になるだけでなく、スロークエリの改善や実務でのテーブル設計時に迷わず最適な判断ができるようになります。ぜひ基礎をしっかりマスターしておきましょう!
以上で本記事の解説を終わります。
よいITライフを!
ITエンジニアにお勧めの本 ↗

エンジニアが知っておきたい思考の整理術 複雑な情報を【理解する】【伝える】テクニック
思考の整理というテーマを、実務ですぐに使える具体的な「技術」として落とし込んだ一冊です。
おすすめ
1 / 5人気記事
- 1
- 2
- 3
- 4
- 5
思考の整理というテーマを、実務ですぐに使える具体的な「技術」として落とし込んだ一冊です。