Pythonユーザにお勧めの本 ↗

スッキリわかるPython入門 第2版 スッキリわかるシリーズ
対話形式でスラスラ読める。複雑な概念もキャラクターが分かりやすく解説してくれます。

言語仕様を深く解説。なんとなく書ける状態から、自信を持って書ける状態へ引き上げてくれます。

Python1年生 第2版 体験してわかる!会話でまなべる!プログラミングのしくみ
イラスト中心で、プログラミングの楽しさを教えてくれる。ワクワクしながら学べる入門書です。
PythonPython [パイソン]汎用プログラミング言語でデータをまとめて保持するためのクラスを定義するとき、__init__ や __repr__、__eq__ などの特殊メソッドを毎回手作業で書くのは手間がかかります。
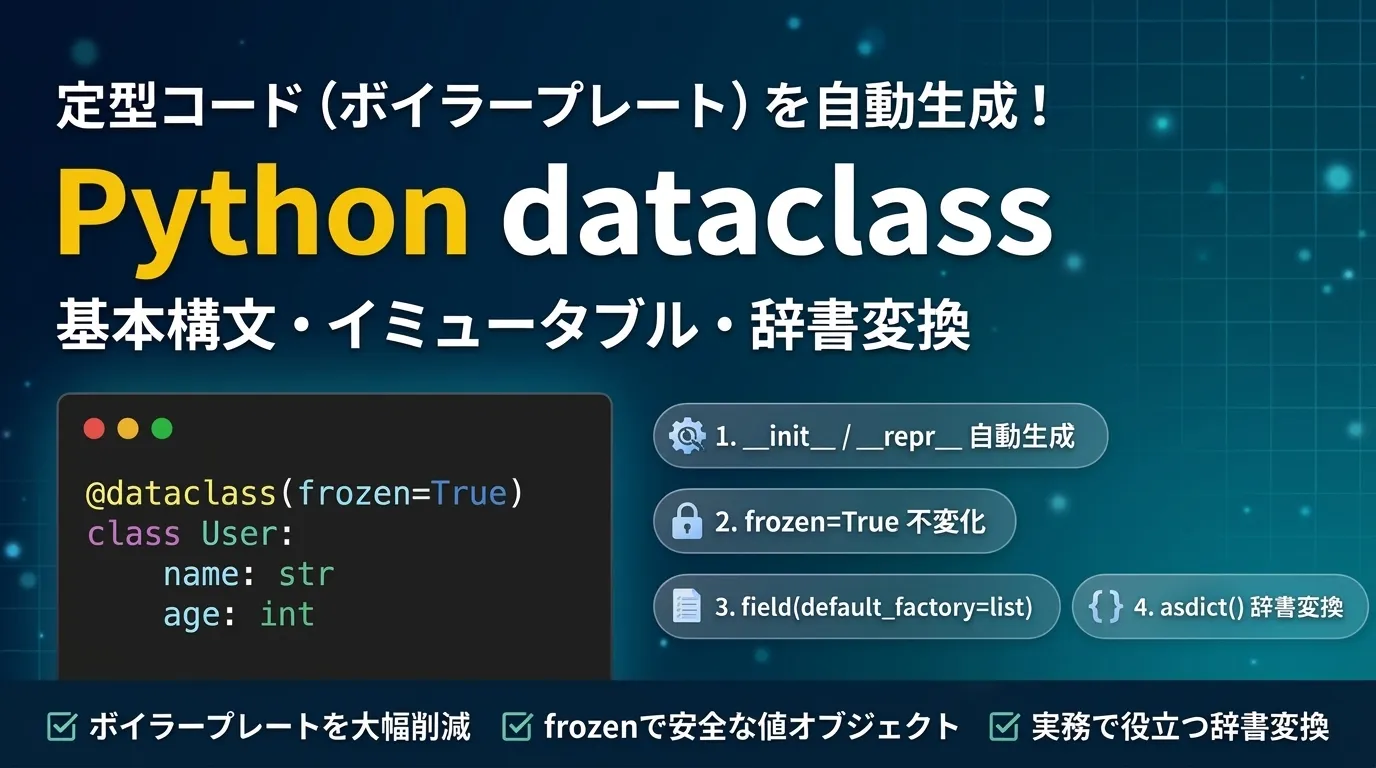
Python 3.7で標準ライブラリとして導入された dataclasses モジュールの @dataclass デコレータ(デコレータの仕組みは Pythonデコレータの解説 を参照)を利用すると、これらの定型的なコード(ボイラープレート)を自動生成できます。可読性が向上するだけでなく、記述ミスを減らし、保守性の高いコードを実現できます。
この記事では、dataclass の基本的な書き方から、自動生成されるメソッドの挙動、frozen による不変オブジェクトの作成、ミュータブルなデフォルト値を扱う field 関数の使い方、辞書への変換やバリデーションまでを実機検証したコードとともに分かりやすく解説します。
この記事でわかること
- 通常のクラス定義と
dataclassの違いおよびメリット @dataclassで自動生成される特殊メソッド(__init__,__repr__,__eq__)の挙動- デフォルト値の定義ルールと
field(default_factory=...)が必要な理由 frozen=Trueを使って属性への再代入を防ぐ方法(浅い不変性の仕様と注意点)asdict()やastuple()を用いた辞書・タプルへの変換方法__post_init__を活用した値のバリデーションや初期化処理
確認した環境
本記事で解説するコードおよび出力結果は、以下の環境で動作を確認しています。
- OSOS [オーエス]Operating System。基本ソフトウェア: DebianDebian [デビアン]コミュニティ主導で開発される安定性の高いLinuxディストリビューション GNU/LinuxLinux [リナックス / ライナックス]オープンソースのOSカーネル 11 (bullseye) / UbuntuUbuntu [ウブントゥ]人気のLinuxディストリビューション 22.04 LTS
- 言語: Python 3.9 / 3.10 / 3.11 / 3.12(dataclasses は標準ライブラリのため追加インストール不要)
dataclassとは?通常のクラス定義との違い
dataclass は、主に「データを保持すること」を目的としたクラスを簡潔に定義するためのデコレータです。
まずは通常のクラス定義と比較して、どれほどコードを削減できるかを確認してみましょう。
通常のクラス定義で発生する定型コード
通常のクラス定義では、属性の代入、文字列表現の定義、等価性比較のために以下のような定型コードを記述する必要があります。
class User: def __init__(self, name: str, age: int): self.name = name self.age = age
def __repr__(self) -> str: return f"User(name={self.name!r}, age={self.age!r})"
def __eq__(self, other: object) -> bool: if not isinstance(other, User): return False return self.name == other.name and self.age == other.age
u1 = User("佐藤", 28)u2 = User("佐藤", 28)
print(u1)print(u1 == u2)実行結果:
User(name='佐藤', age=28)True属性が増えるたびに __init__、__repr__、__eq__ のすべてに修正を加える必要があり、コードの保守が煩雑になります。
dataclassを使った簡潔な書き方
@dataclass デコレータを使用すると、型ヒントを付けて属性を並べるだけで、基本的なデータの保持や文字列表現、等価性比較を行えるクラスを簡潔に定義できます。
from dataclasses import dataclass
@dataclassclass User: name: str age: int
u1 = User("佐藤", 28)u2 = User("佐藤", 28)
print(u1)print(u1 == u2)実行結果:
User(name='佐藤', age=28)Trueわずか数行の記述で、__init__ による引数の受け取り、見やすい文字列表現(__repr__)、属性値が同じであれば等しいと判定する比較処理(__eq__)がすべて利用可能になります。
自動生成される主要な特殊メソッド
@dataclass はクラス定義時に以下の特殊メソッドを自動的に生成します。
__init__(): 型アノテーションが付けられたフィールドを引数に取るコンストラクタ__repr__(): クラス名と各フィールドの値を整形した文字列表現(デバッグに最適)__eq__(): 同一クラスのインスタンス間で各フィールドの値が一致しているかを比較する判定処理(継承した別クラスなど型が異なる場合は一致とみなされない点に注意)
なお、 dataclass は型アノテーションを利用してフィールドを認識しますが、 実行時に値の型を自動検証する機能はありません 。例えば、以下のように age: int と定義していても、実行時に文字列を渡すこと自体はエラーになりません。
from dataclasses import dataclass
@dataclassclass User: name: str age: int
user = User("佐藤", "28")print(user)実行結果:
User(name='佐藤', age='28')型ヒントは主に IDEIDE [アイディーイー]Integrated Development Environment。統合開発環境 の補完や静的型チェックツール(mypy や Pyright など)で利用される情報です。実行時にも型の整合性を確認したい場合は、後述の __post_init__() などで明示的に検証するか、pydantic などのライブラリを併用する必要があります。
デフォルト値の設定とfield関数の活用
実務では、フィールドに初期値(デフォルト値)を持たせたい場面が多くあります。dataclass でも通常の変数代入と同じ記法でデフォルト値を設定できます。
基本的なデフォルト値の設定
デフォルト値を持つフィールドは、デフォルト値のないフィールドよりも後に定義する必要があります。これは Python の関数の引数ルールと同じです。
from dataclasses import dataclass
@dataclassclass User: name: str age: int is_active: bool = True # デフォルト値を設定
user = User("鈴木", 30)print(user)実行結果:
User(name='鈴木', age=30, is_active=True)リストや辞書のデフォルト値にはfield(default_factory=…)を使う
リスト(list)や辞書(dict)などのミュータブル(可変)なオブジェクトを直接デフォルト値に設定すると、Python のバージョンに応じて ValueError または TypeError が発生します。
- Python 3.9:
list、dict、setを直接指定するとValueErrorが発生します。 - Python 3.10:
list、dict、setを直接指定するとTypeErrorが発生します。 - Python 3.11 以降: ハッシュ不可能(unhashable)なオブジェクト全般が禁止対象となり、
ValueErrorが発生します。
from dataclasses import dataclass
@dataclassclass Item: name: str tags: list = [] # Python 3.9・3.11以降は ValueError、3.10は TypeErrorエラー出力例(Python 3.11 以降):
ValueError: mutable default <class 'list'> for field tags is not allowed: use default_factory※ Python 3.9 環境では ValueError、Python 3.10 環境では同じメッセージの TypeError(TypeError: mutable default <class 'list'> for field tags is not allowed: use default_factory)が発生します。
これは、すべてのインスタンスで同一のリストオブジェクトが共有されてしまうバグを防ぐための仕様です。
可変オブジェクトをデフォルト値にする場合は、field 関数の default_factory 引数にファクトリ関数(list や dict)を指定します。
from dataclasses import dataclass, field
@dataclassclass Item: name: str tags: list[str] = field(default_factory=list)
item1 = Item("ノートPC")item1.tags.append("PC")
item2 = Item("マウス")
print("item1:", item1)print("item2:", item2)実行結果:
item1: Item(name='ノートPC', tags=['PC'])item2: Item(name='マウス', tags=[])default_factory=list を指定することで、インスタンスが生成されるたびに新しい空リストが個別に生成され、インスタンス間での意図しないデータ共有を防ぐことができます。
実務で役立つ実践テクニック
ここからは、実務のアプリケーション開発やデータ処理で役立つ3つの実践機能を紹介します。
1. frozen=True でイミュータブル(不変)にする
APIAPI [エーピーアイ]Application Programming Interface。異なるソフトウェア間の接続口 のレスポンスや設定情報など、生成後に値を変更されたくないデータ構造には @dataclass(frozen=True) を指定します。
from dataclasses import dataclass
@dataclass(frozen=True)class AppConfig: host: str port: int
config = AppConfig("127.0.0.1", 8080)print("host:", config.host)
# 値の変更を試みるtry: config.port = 9000except Exception as e: print("発生した例外:", type(e).__name__) print("エラーメッセージ:", e)実行結果:
host: 127.0.0.1発生した例外: FrozenInstanceErrorエラーメッセージ: cannot assign to field 'port'frozen=True を指定すると、インスタンスの属性への通常の代入や削除が禁止され、変更しようとすると FrozenInstanceError が発生します。
ただし、 frozen=True は 浅い不変性 を提供するものであり、オブジェクト内部のすべてのデータを不変にするわけではありません。list や dict などのミュータブルなオブジェクトをフィールドに持つ場合、以下のように属性の再代入は防げても、その内部の要素までは変更できてしまいます。
from dataclasses import dataclass
@dataclass(frozen=True)class User: name: str tags: list[str]
user = User("佐藤", ["Python"])# 属性への代入はできない(FrozenInstanceError)# user.name = "鈴木"
# リストなど可変オブジェクトの中身は変更できてしまうuser.tags.append("Linux")print(user.tags)実行結果:
['Python', 'Linux']さらに、辞書のキーや set の要素として使えるかどうかにも注意が必要です。frozen=True とデフォルトの eq=True を組み合わせると __hash__() が自動生成されるため、 すべてのフィールドの値がハッシュ可能であれば 、辞書のキーや set の要素として利用できます。例えば、str や int、 ハッシュ可能な要素だけで構成された tuple などが該当します。一方で、tuple であっても内部にリストなどのハッシュ不可能な要素を含む場合(例: ("Python", [1, 2, 3]))や、上記の User のように list フィールドを持つ場合は、hash() 呼び出し時や辞書・set への格納時に TypeError が発生します。
2. asdict() と astuple() による相互変換
dataclass のインスタンスを辞書やタプルに変換するには、asdict() および astuple() 関数を使用します。ネストしたデータクラスも再帰的に辞書やタプルへ変換してくれるため、JSONJSON [ジェイソン]JavaScript Object Notation。軽量データ交換フォーマット で扱える型のデータであれば json.dumps() と組み合わせて簡単に JSON 文字列へ変換できます。ただし、asdict() 自体はデータクラスを辞書に変換する関数(その他のオブジェクトは copy.deepcopy() で複製)であり、datetime や独自クラスなど JSON が直接扱えない型を含む場合は、別途変換処理が必要になる点に注意してください。
import jsonfrom dataclasses import dataclass, asdict, astuple
@dataclassclass Book: title: str price: int authors: list[str]
book = Book("Python実践入門", 3200, ["山田太郎", "鈴木花子"])
# 辞書への変換book_dict = asdict(book)print("辞書型:", book_dict)
# JSON文字列への変換json_text = json.dumps(book_dict, ensure_ascii=False)print("JSON形式:", json_text)
# タプルへの変換book_tuple = astuple(book)print("タプル型:", book_tuple)実行結果:
辞書型: {'title': 'Python実践入門', 'price': 3200, 'authors': ['山田太郎', '鈴木花子']}JSON形式: {"title": "Python実践入門", "price": 3200, "authors": ["山田太郎", "鈴木花子"]}タプル型: ('Python実践入門', 3200, ['山田太郎', '鈴木花子'])3. post_init で値の検証(バリデーション)を行う
dataclass では __init__ が自動生成されますが、インスタンス生成直後に追加の初期化やバリデーションを行いたい場合は __post_init__() メソッドを定義します。
from dataclasses import dataclass
@dataclassclass Product: name: str price: int
def __post_init__(self): if self.price < 0: raise ValueError("価格は0以上である必要があります")
# 正常なインスタンス生成p = Product("消しゴム", 100)print(p)
# 不正な値のテストtry: Product("不良データ", -50)except ValueError as e: print("バリデーションエラー:", e)実行結果:
Product(name='消しゴム', price=100)バリデーションエラー: 価格は0以上である必要があります__post_init__() を定義しておけば、不正な値を持つインスタンスの生成を事前に阻止できます。
なお、__post_init__() は @dataclass が自動生成した __init__() から呼び出される仕組みです。そのため、クラスに独自の __init__() を定義した場合(または @dataclass(init=False) とした場合)は __post_init__() が自動的には呼び出されません。独自の __init__() を実装する際は、必要に応じて明示的に __post_init__() を呼び出す必要があります。
他のデータ構造との比較と使い分け
Python にはデータをまとめる手法として、通常のクラスのほかに「辞書(dict)」「namedtuple」「pydantic」などがあります。用途に応じた最適な使い分けの目安は以下のとおりです。
| 手法 | 標準機能 | 型ヒント | 不変性 | 実行時バリデーション | 主な適正用途 |
|---|---|---|---|---|---|
辞書(dict) | ⭕ | ⭕(dict[str, int] や TypedDict で指定可) | ❌(可変) | ❌ | 一時的なキー・バリュー保持、スキーマ不定のデータ |
namedtuple | ⭕ | ⭕(NamedTuple) | ⭕(常に不変) | ❌ | 軽量なタプル拡張、メモリ効率重視 |
dataclass | ⭕ | ⭕(必須) | 選択可(frozen / 浅い不変性) | △(手動で実装) | 内部ロジックのデータ構造、値オブジェクト、設定値 |
pydantic | ❌(要外部導入) | ⭕ | 選択可 | ⭕(自動型変換あり) | FastAPI 等の Web API 入出力、外部入力の厳格な検証 |
※ dict[str, int] や TypedDict、dataclass の型ヒントはいずれも静的型チェック向けであり、通常の Python 実行時に値の型を自動検証するものではありません。
標準ライブラリだけで完結させたい場合や、社内ツール・内部処理で構造化データをきれいに扱いたい場合は dataclass が最も有力な選択肢です。Python の基本的な辞書操作については Python辞書の使い方、タプルの活用法については Pythonタプルの使い方 も参考にしてください。一方で、外部からのリクエストボディの型検証や自動キャストが必要な Web API 開発では pydantic を検討すると良いでしょう。
まとめ
この記事では、Python の dataclass について基本的な構文から実務で頻繁に使われる応用テクニックまでを解説しました。
押さえておきたい要点
@dataclassを付与することで、__init__、__repr__、__eq__などの定型コードを自動生成できる- リストや辞書などの可変オブジェクトをデフォルト値にする際は、
field(default_factory=list)を使用する(直接指定すると Python 3.9・3.11 以降はValueError、3.10 はTypeError) - 属性への再代入を防ぎたいデータは
@dataclass(frozen=True)を活用する(ただしフィールド内部の可変オブジェクト自体は変更できる「浅い不変性」である点に注意) asdict()を使えば再帰的に辞書へ変換でき、JSON 対応型であればjson.dumps()で簡単にシリアライズできる- 生成時のバリデーションや追加計算を行いたい場合は、
__post_init__()を活用する(独自__init__()を定義した場合は自動呼び出しされない点に注意)
dataclass を活用することで、ボイラープレートを大幅に削減しながら安全で可読性の高い Python コードを記述できます。ぜひ日々の開発で活用してみてください。
あわせて読みたい
Pythonの基礎から応用的な構文・データ構造まで体系的に学びたい方は、以下の記事もあわせてご覧ください。
Python入門|基礎文法・環境構築・ライブラリ活用まとめ
Pythonの学習に必要な情報を網羅的にまとめた完全ガイドです。環境構築から基礎文法、オブジェクト指向、テスト、応用ライブラリまで、目的別に分かりやすく整理しています。初心者から中級者へのステップアップにぜひご活用ください。

【Python】辞書型(dict)| 追加・取り出し・ソート方法
Pythonの辞書型(dict)は、データをキーと値のペアで管理するデータ構造です。本記事では、辞書型の基本から、操作方法、イテレーション、応用例、さらには辞書内包表記やJSONとの連携方法まで詳しく解説します。辞書を活用することで、データ管理をより効率的に行うことができます。

【Python】デコレータ徹底解説|基礎からわかりやすく解説!
Pythonのデコレータは、関数やクラスの振る舞いを柔軟に拡張できる便利な機能です。本記事では、初心者でも理解しやすいコード例と実行結果を交えて、デコレータの基本的な仕組みから、実践的な応用例まで詳しく解説します。Pythonの開発を効率化し、可読性の高いコードを書けるようになりましょう!
以上で本記事の解説を終わります。
よいITライフを!
Pythonユーザにお勧めの本 ↗

「絶対に挫折させない」という著者の強い意志を感じる、プログラミングの「最初の1冊」としておすすめできる良書です。
Pythonのおすすめ
1 / 4人気記事
- 1
- 2
- 3
- 4
- 5
「絶対に挫折させない」という著者の強い意志を感じる、プログラミングの「最初の1冊」としておすすめできる良書です。